Was ist Claude AI — und brauchst du das überhaupt?
Was Claude AI wirklich ist: vier Dinge unter einem Namen — die Modelle, claude.ai, Claude Code und die API — wo es hilft und wo es enttäuscht.
 Manuel Hedinger
Fast jede Woche fragt mich jemand dasselbe: «Was ist Claude AI eigentlich — und brauche ich das?» Meistens folgt darauf eine Antwort aus einem Marketing-Text. Ich arbeite seit über zwei Jahren praktisch täglich mit Claude, in echten Kundenprojekten. Das hier ist die Antwort, die ich gebe, wenn niemand etwas verkaufen will.
Die kurze Antwort
Claude ist ein KI-Assistent der Firma Anthropic. Technisch gesehen ein grosses Sprachmodell (LLM): ein System, das Text versteht und Text produziert. Inzwischen liest es auch Bilder, analysiert Dateien, schreibt Code und tut über Werkzeuge selbstständig Dinge.
Vergleichbar mit ChatGPT von OpenAI oder Gemini von Google. Der Unterschied liegt weniger in einer einzelnen Funktion als im Zuschnitt: Claude ist auffällig stark bei langen, strukturierten Texten, bei Code und bei Aufgaben, in denen man dem Ergebnis vertrauen können muss, weil es ungeprüft weiterläuft.
Was «Claude» konkret meint
«Claude AI» ist ein Sammelbegriff. Genau das stiftet die meiste Verwirrung. Dahinter stecken mehrere Dinge:
- Die Modelle. Aktuell die Claude-5-Familie — Opus 5 als stärkstes Modell, Sonnet 5 als Allrounder, dazu Haiku für schnelle, günstige Aufgaben. Das Modell ist der Motor, nicht das Auto.
- claude.ai. Die Chat-Oberfläche im Browser und als App. Das ist es, was die meisten Leute meinen, wenn sie «Claude» sagen.
- Claude Code. Ein Assistent, der direkt im Terminal und in der IDE arbeitet: liest deine Dateien, ändert sie, führt Befehle aus. Für mich das mit Abstand wichtigste Werkzeug der letzten zwei Jahre.
- Die API. Der Zugang für Entwickler, um Claude in eigene Software einzubauen — Kundenportale, interne Tools, Automatisierungen.
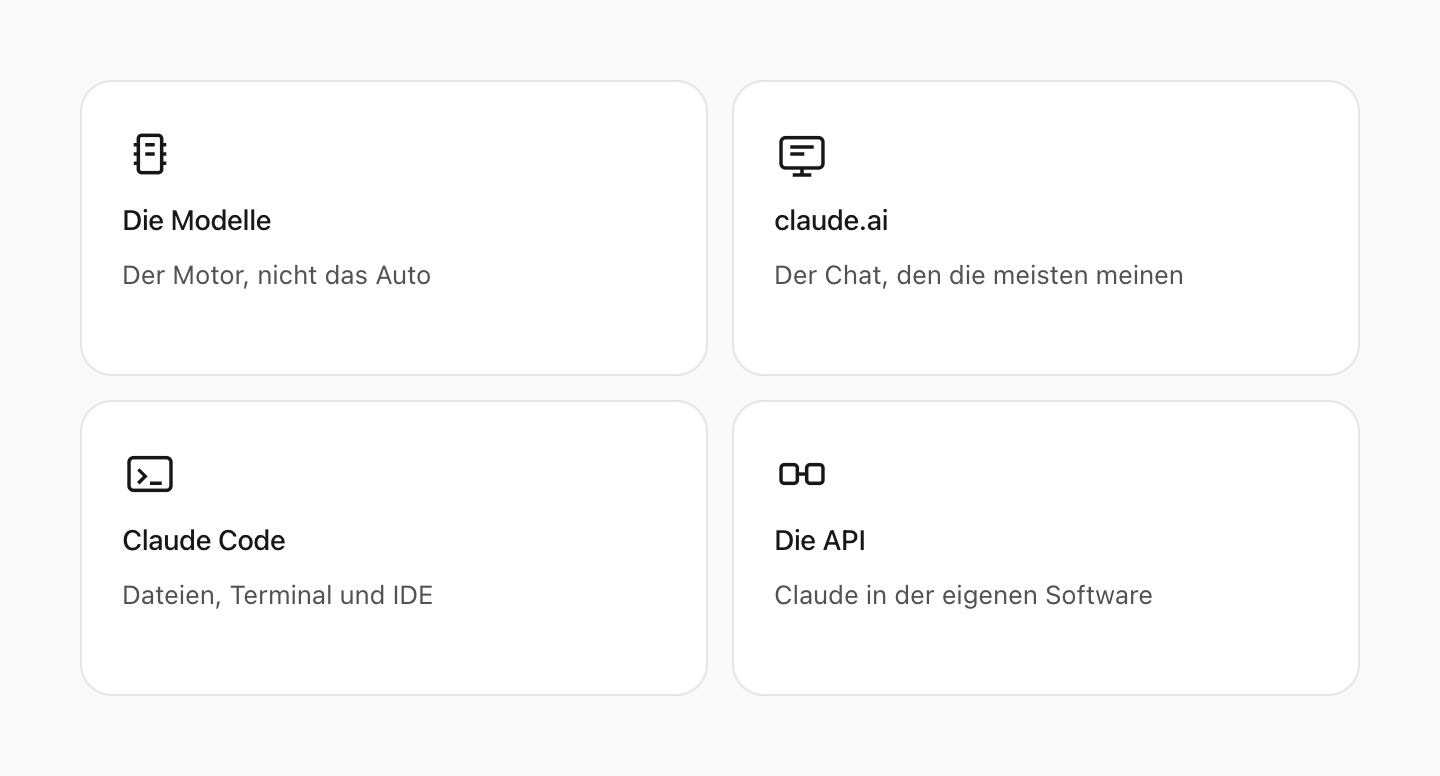
Wer «brauche ich Claude?» fragt, meint fast nie dasselbe wie sein Gegenüber. Die Antwort hängt davon ab, welche dieser vier Ebenen gemeint ist.
Was es in der Praxis wirklich verändert
Der Gewinn liegt selten dort, wo die Demos ihn zeigen.
Massiv hilft es überall dort, wo viel Kontext im Spiel ist und trotzdem Struktur herauskommen muss. Eine 40-seitige Ausschreibung auf die drei Punkte reduzieren, die für eine Offerte zählen. Eine gewachsene Codebasis erklären lassen, bevor man sie anfasst. Einen Vertragsentwurf gegen die eigenen Standardbedingungen durchgehen. Migrationsarbeit, die stur, gross und langweilig ist.
Enttäuschend wird es, sobald das Problem nicht klar formuliert ist. Ein Modell macht eine unklare Anforderung nicht klarer, es füllt die Lücke mit etwas Plausiblem. Und plausibel ist gefährlicher als offensichtlich falsch. Der Engpass verschiebt sich vom Tippen zum Denken — eine gute Nachricht nur für Leute, die vorher schon gedacht haben.
Was in den Demos nie vorkommt: Der grösste Effekt bei mir war nicht Geschwindigkeit, sondern dass ich Dinge überhaupt anfange, die ich früher aufgeschoben hätte. Das kleine interne Tool, die Testabdeckung, die Dokumentation. Die Anfangshürde ist weg.
Der Punkt, an dem es ernst wird
Fast jedes Gespräch landet irgendwann beim Datenschutz — und zu Recht. Ein paar Dinge, die man wissen sollte:
Anthropic verwendet Inhalte aus der API-Nutzung standardmässig nicht für das Training der Modelle. Bei den Consumer-Abos ist die Lage anders und hängt an den Einstellungen, die man einmal bewusst setzen muss. Für Geschäftsdaten führt der Weg über die API oder einen Enterprise-Vertrag, nicht über das private Login eines Mitarbeitenden.
Dazu kommt die Frage, wo verarbeitet wird. Wer mit regulierten Daten arbeitet, braucht eine Antwort auf Auftragsverarbeitung, Serverstandort und Löschfristen — bevor der erste Kundendatensatz in ein Chatfenster kopiert wird. Diese Antwort ist erarbeitbar, sie entsteht aber nicht von selbst.
Meine Faustregel: Wenn ein Datensatz nicht in eine E-Mail an einen externen Dienstleister dürfte, gehört er auch nicht ungeprüft in ein Chatfenster.
Wie ich einsteigen würde
Wenn du bei null anfängst, würde ich es genau so machen:
- Eine Woche lang normal arbeiten, aber laut denken. Jede Aufgabe, bei der du dir denkst «das ist stumpfsinnig», notieren. Das ist deine Liste.
- Die drei stumpfsinnigsten Aufgaben zuerst. Nimm die langweiligste mit dem klarsten Ergebnis, nicht die spannendste. Dort merkst du sofort, ob es taugt.
- Kontext geben, nicht Anweisungen bellen. Der Unterschied zwischen einem brauchbaren und einem unbrauchbaren Ergebnis ist fast immer, wie viel Hintergrund im Prompt steht. Beispiele schlagen Adjektive.
- Alles prüfen, was Konsequenzen hat. Zahlen, Namen, Rechtsverweise, Quellen. Ein Modell klingt sicher, auch wenn es rät.
- Erst dann automatisieren. Was du dreimal von Hand gemacht hast und was dreimal gut war, lohnt sich als API-Anbindung. Vorher nicht.
Lohnt es sich?
Für Wissensarbeit mit viel Text, Code oder Recherche: ja, ziemlich eindeutig. Für Betriebe, deren Arbeit vor allem aus physischen Abläufen und wenigen, stabilen Prozessen besteht: deutlich weniger — und ehrlicherweise oft noch nicht.
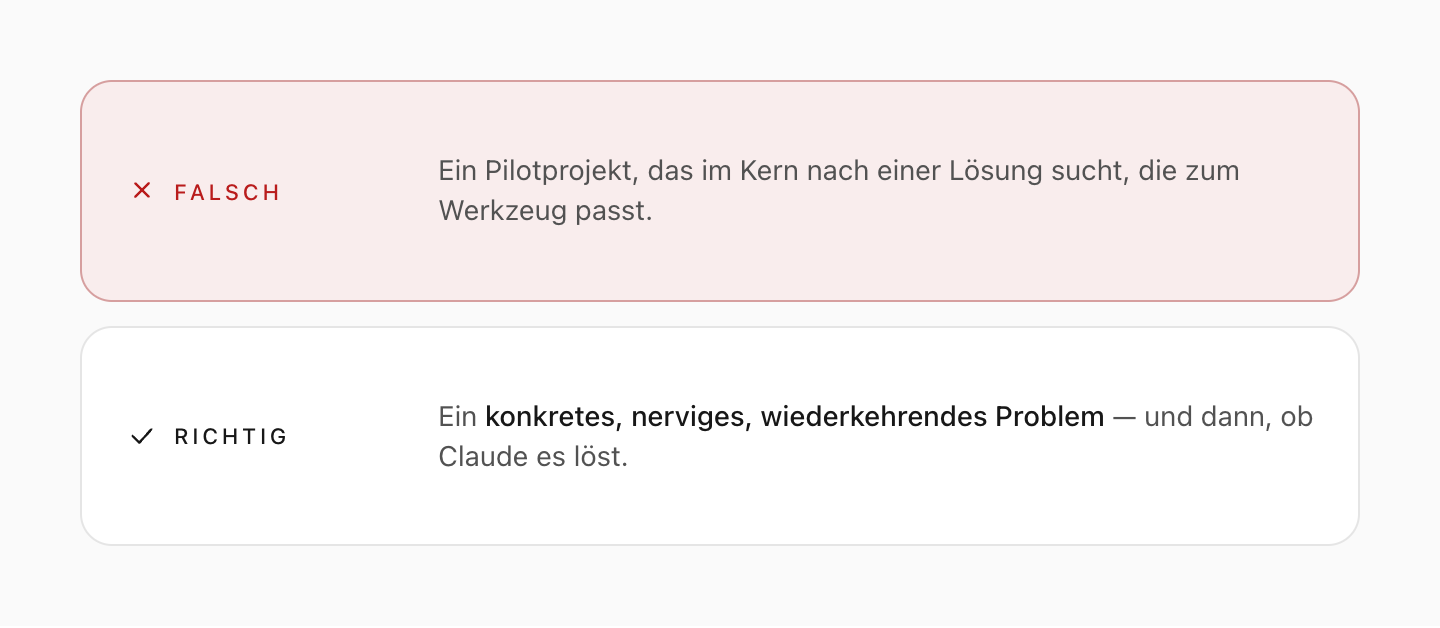
Was ich niemandem empfehle, ist das Pilotprojekt, das eigentlich nach einer Lösung sucht, die zum Werkzeug passt. Umgekehrt funktioniert es: ein konkretes, wiederkehrendes Problem, das nervt — und dann die Frage, ob Claude es löst.
Falls du gerade an genau so einem Problem sitzt und unsicher bist, ob sich der Aufwand lohnt: schreib mir. Eine ehrliche Einschätzung kostet nichts — und manchmal lautet sie «lass es».